

Seit heute ist Cohereny veröffentlicht, als Open Source unter der AGPLv3. Der Quellcode liegt auf GitHub, die Projektseite ist cohereny.com. Hier erzähle ich, was Cohereny ist, warum es das gibt und was davon heute funktioniert. Wer tiefer einsteigen will, findet im Repository die Architektur mit allen Entscheidungen und ihren Begründungen.
Das Problem
Ein Prompt, der auf einem Modell gut funktioniert, funktioniert auf einem anderen oft schlechter. Nicht weil das andere Modell schwächer wäre, sondern weil es eine andere Struktur, einen anderen Ton und ein anderes Format erwartet. Drei Effekte kommen zusammen, und bei jedem Modellwechsel fallen sie aufs Neue an:
- Modell-Varianz: Derselbe Prompt verhält sich auf verschiedenen Modellen unterschiedlich.
- Model Drift: Dasselbe Modell verhält sich nach einem Update anders.
- Prompt Sensitivity: Kleine Änderungen an der Formulierung ändern das Ergebnis.
In einem Workflow mit mehreren Schritten und mehreren Modellen braucht jeder Schritt seinen eigenen, passenden Kontext. Und jeder ist allen drei Effekten zugleich ausgesetzt.
Wie es angefangen hat
Ein KI-System kann einwandfrei laufen, lückenlos protokolliert sein und trotzdem über Wochen leise schlechter werden, weil keine Kontrolle misst, was inhaltlich herauskommt. Diese Erfahrung habe ich in einem privaten Projekt gemacht, und im Austausch mit Bekannten bin ich ihr wieder begegnet.
Sie hat mich nicht losgelassen, und ich wollte wissen, ob es besser geht. Also habe ich es ausprobiert: weil es geht, weil es mir Spaß macht und weil ich praktisch erproben wollte, was funktioniert und was nicht. Die Frage dahinter ist bis heute die, an der Cohereny arbeitet: Wie baut man einen Workflow aus mehreren Sprachmodellen so, dass er nachvollziehbar bleibt, auch wenn sich die Modelle darunter ändern?
Der Ansatz: Kontext gehört nicht in den Code
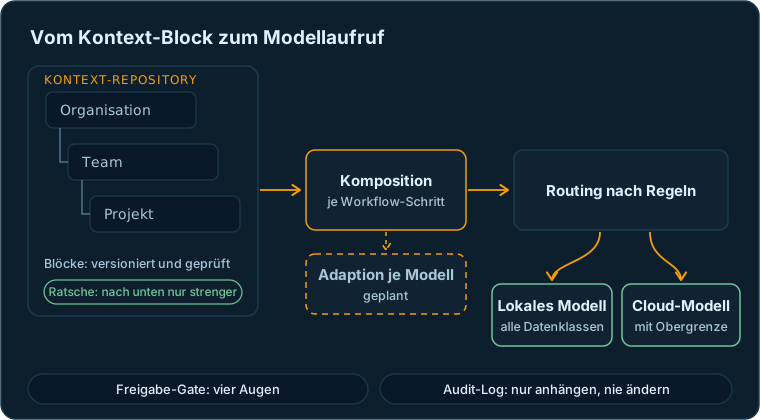
Cohereny hält den Kontext außerhalb des Anwendungscodes, in einem Repository, das alle Teams teilen: System-Prompts, Fachwissen, Beispiele, Werkzeugbeschreibungen, Routing-Regeln. Jeder Eintrag ist ein versionierter Block, der erst nach einer Prüfung gilt. Zugeordnet ist er einem Geltungsbereich: einer Organisation, einem Team, einem Projekt oder einer einzelnen Person.
Zur Laufzeit setzt Cohereny für jeden Workflow-Schritt genau den Kontext zusammen, den dieser Schritt braucht, und übergibt ihn dem Modell, das die Routing-Regeln wählen.
Ein paar Eigenschaften, die mir dabei wichtig waren:
- Freigabe statt Direktänderung. Ein Block wird geschrieben, eingereicht und freigegeben. Was eine Person über ein Modell lernt, landet im Repository, wo alle etwas davon haben, nachdem jemand draufgeschaut hat.
- Die Datenschutz-Ratsche. Weiter unten im Baum darf eine Datenschutzregel nur strenger werden, nie lockerer. Ein Projekt kann strenger sein als seine Organisation, aber nicht nachlässiger.
- Die Daten bestimmen das Modell. Jeder Geltungsbereich trägt eine Datenklasse, jedes Modell eine Obergrenze. Was das eigene Netz nicht verlassen darf, geht an kein Modell in der Cloud.
- Menschen an den entscheidenden Stellen. Kein Workflow ohne Freigabe-Gate: Cohereny aktiviert keinen Workflow, in dem ein Modellaufruf ohne menschliche Prüfung endet, und ein Gate kann nach dem Vier-Augen-Prinzip arbeiten.
- Nichts verschwindet. Ins Audit-Log wird nur geschrieben, geändert wird darin nichts. Es hält fest, wer was wann freigegeben hat.
- Headless. Jede Funktion ist zuerst ein API-Endpunkt, getrennt in vier API-Bereiche für Abfragen, Pflege, Beobachtung und Verwaltung, alle durch OpenID Connect geschützt.
Was gebaut ist und was noch nicht
Cohereny ist aktuell eine Pre-Release-Version und nicht für den Produktivbetrieb gedacht, die API wird sich noch ändern. Was schon gebaut ist, steht auf GitHub, die Roadmap auf cohereny.com.
Gebaut und mit Tests abgedeckt:
- das Kontext-Repository mit versionierten Blöcken, Prüf-Lebenszyklus und Freigabe je Geltungsbereich
- die Komposition entlang des Geltungsbereichsbaums samt Datenschutz-Ratsche
- Routing-Regeln als geprüfte Blöcke, mit Datenklassen je Geltungsbereich und Obergrenzen je Modell
- der Workflow-Runner mit Verzweigungen, Zusammenführungen und Freigabe-Gates
- das Audit-Log und die API je Bereich, geschützt durch OpenID Connect
In Arbeit ist der Benchmark. Kalibrieranker und Messtabellen stehen, die Läufe gegen die konfigurierten Modelle folgen. Er soll öffentlich nachvollziehbar zeigen, ob und wie viel eine Anpassung des Kontexts an das Modell bringt. Und er ist das Stück, das in der Erfahrung oben gefehlt hat: eine Messung dessen, was inhaltlich herauskommt.
Geplant ist die eigentliche Adaption: Prompt und Kontext modellgerecht anpassen, abgeleitet aus den Benchmark-Ergebnissen. Um diesen Teil geht es bei Cohereny letztlich. Als fertig beschreibe ich ihn erst, wenn die Messung zeigt, dass er wirkt.
Wie Cohereny gebaut wird
Cohereny ist ein privates Projekt: entstanden in meiner Freizeit, auf eigener Hardware, mit eigenen Konten und Lizenzen und mit privaten, also auch sehr begrenzten Mitteln. Die Entwicklung läuft auf einem selbst betriebenen GitLab, das Repository auf GitHub ist ein Schnappschuss davon.
Gebaut ist es trotzdem so, wie es sich meiner Meinung nach für ein ordentliches Softwareprojekt gehört, auch wenn ich allein daran arbeite:
- Coding Conventions, die automatisch geprüft werden
- Tests zu jeder Änderung, mit Gegenprobe: Der Test führt vor, dass ein Schutz greift, die Gegenprobe zeigt, dass er ohne die Änderung nicht greifen würde
- kein Commit ohne Ticket, kein Merge ohne Review
- Architekturentscheidungen als ADR, in einer arc42-Dokumentation samt Whitepaper, beides auf Deutsch und im Repository
Das gilt genauso für meinen Coding Buddy Claude Code, mit dem ein großer Teil des Codes entsteht. Jede seiner Änderungen habe ich mir angesehen, geprüft und freigegeben, oder eben auch nicht. Wie ich mit Claude Code arbeite, steht in „Claude Code: Hilfreich, aber kein Freifahrtschein“.
Ein paar Zahlen zum heutigen Stand:
| Kennzahl | Stand |
|---|---|
| Unit-Tests ohne jeden Dienst | 1.382 |
| Integrationstests gegen eine echte PostgreSQL | 70 |
| Zeilenabdeckung ohne die beiden alten Piloten | 91 % |
| … im Kernel (Identität, Rollen, Berechtigungen, Audit) | 97 % |
Die Pipeline fällt, wenn die Abdeckung um mehr als einen halben Punkt sinkt.
Warum Open Source, und warum AGPLv3
Ein Werkzeug, das Nachvollziehbarkeit verspricht, sollte selbst nachvollziehbar sein. Deshalb ist der Code offen, samt Architektur und Begründungen.
Die AGPLv3 sorgt dafür, dass das so bleibt: Wer eine veränderte Fassung weitergibt oder als Netzwerkdienst betreibt, muss deren Quellcode offenlegen. Für Einsätze, zu denen das nicht passt, etwa eine proprietäre Integration, gibt es auf Anfrage eine kommerzielle Lizenz.
Was als Nächstes kommt
- Die Benchmark-Läufe gegen die konfigurierten Modelle, als Beleg für die Adaption oder gegen sie
- Ein Schnellstart per Docker. Heute muss man PostgreSQL, Redis, einen OIDC-Anbieter und ein LiteLLM-Gateway noch selbst stellen
- Version 1.0, geplant für das erste Quartal 2027
Die Roadmap mit dem aktuellen Stand steht auf cohereny.com.
Mitmachen
Issues sind willkommen. Pull Requests kann ich im Moment noch nicht mergen, weil das Repository auf GitHub ein Schnappschuss ist. Mehr dazu steht in CONTRIBUTING.md. Sicherheitslücken bitte nicht als Issue melden, sondern an [email protected]. Fragen und alles andere an [email protected].
Und wer wissen will, welche Architekturfragen hinter Cohereny stecken: Darüber schreibe ich gerade ein Buch, mehr dazu hier.